Durante años, dejar entrar a un crawler era una decisión casi binaria.
O permitías que recorriera tu sitio o lo bloqueabas.
También en Radar Tech: consulta el Radar Tech completo de esta semana.
La inteligencia artificial rompió esa simplicidad.
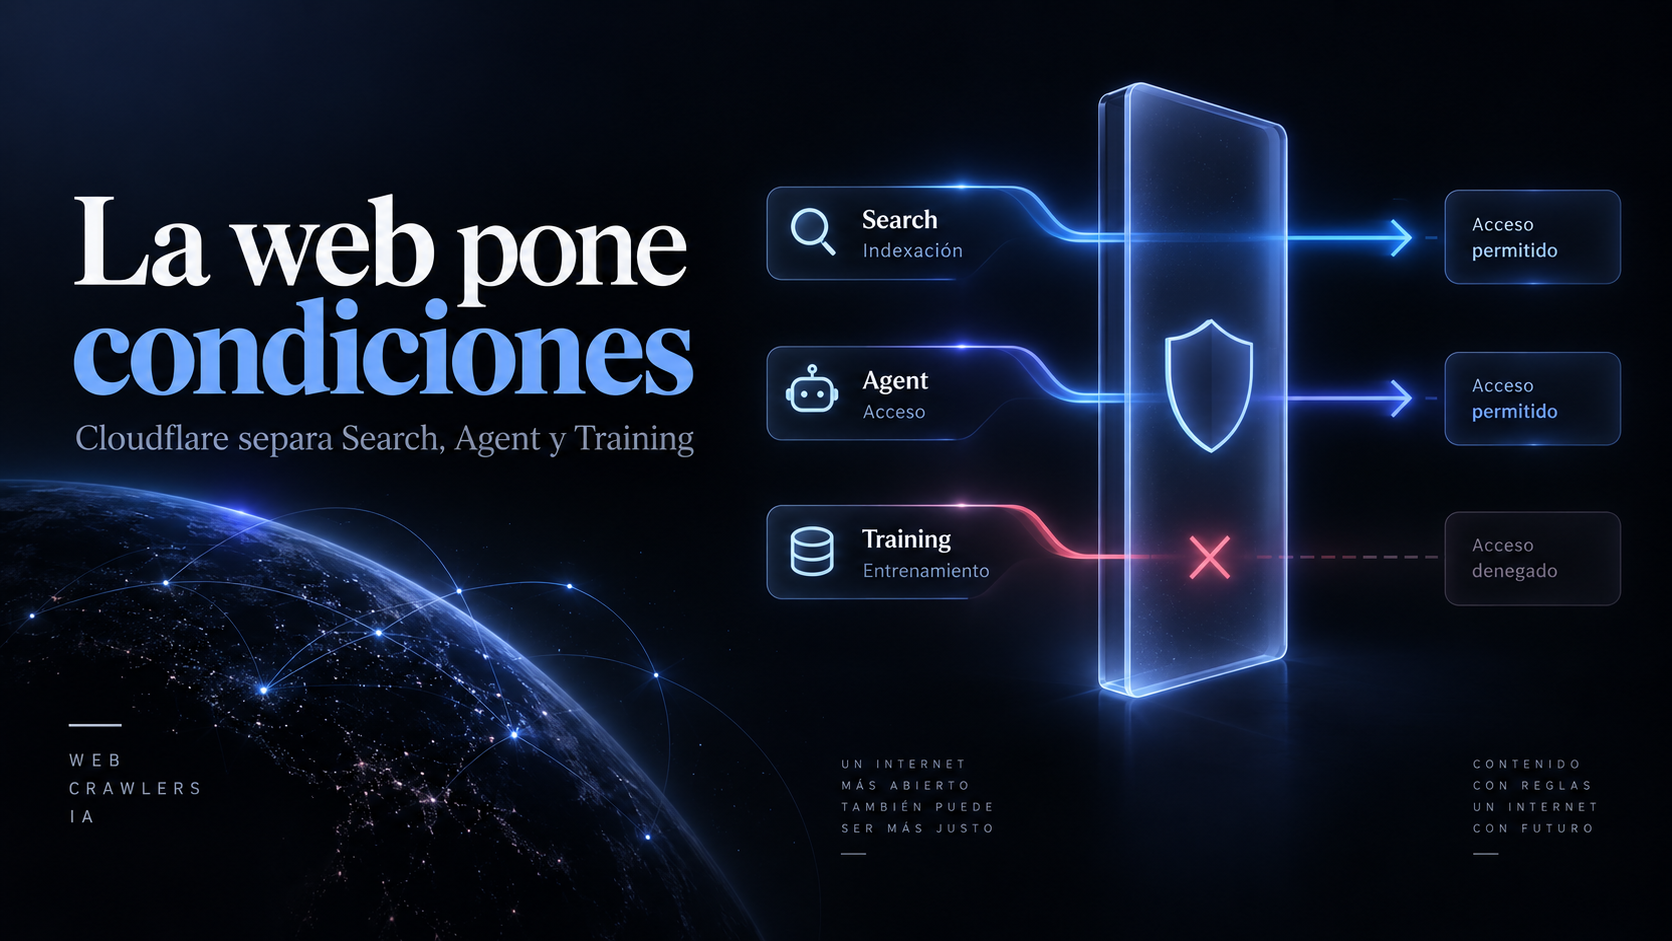
Cloudflare ahora distingue tres comportamientos que antes podían viajar mezclados dentro del mismo bot: Search, Agent y Training.
No todos los crawlers quieren lo mismo
Search indexa contenido para hacerlo descubrible.
Agent accede a una página en tiempo real para actuar en nombre de una persona o responder una consulta.
Training utiliza contenido para entrenar modelos.
Para un publisher, esos tres usos tienen implicaciones comerciales distintas.
Bloquear entrenamiento no necesariamente significa querer desaparecer de un buscador. Permitir que un agente consulte una página tampoco equivale a autorizar que esa información termine dentro de un dataset de entrenamiento.
Cloudflare intenta separar esas decisiones
La nueva opción Disallow AI Training permite mantener contenido disponible para Search mientras se expresa una negativa al uso para entrenamiento.
Cloudflare afirma que Apple, Google y Microsoft ya respetan esa configuración o se han comprometido a hacerlo dentro de plazos definidos.
El problema más difícil eran los crawlers de uso mixto.
Si un mismo bot servía para búsqueda y entrenamiento, bloquear uno podía afectar al otro. Cloudflare está intentando introducir una capa de responsabilidad donde el propósito sea explícito.
Los nuevos defaults también cambian
Desde el 15 de septiembre de 2026, Cloudflare aplica configuraciones diferentes para nuevos dominios.
En páginas que muestran publicidad, los bots clasificados como Training o Agent quedan bloqueados por defecto mientras Search permanece permitido. Los propietarios pueden modificar esa configuración.
No es una decisión menor para sitios que dependen de ingresos publicitarios.
Un agente puede consumir el contenido suficiente para responder una pregunta sin generar una visita humana, una impresión publicitaria ni una sesión medible de la manera tradicional.
SEO ya no alcanza para describir el problema
El viejo objetivo era sencillo: ser indexado y rankear.
Ahora aparecen varias preguntas.
¿Quieres que Google indexe tu página? ¿Quieres que ChatGPT la consulte en tiempo real? ¿Quieres aparecer como fuente dentro de una respuesta? ¿Permites que el contenido sea utilizado para entrenar futuros modelos?
No son la misma decisión.
La política de bots se vuelve una decisión editorial
Hasta hace poco, robots.txt era una configuración técnica que rara vez llegaba a una reunión de producto o negocio.
Eso está cambiando.
Para medios, marcas y creadores con archivo propio, decidir qué máquinas pueden acceder a qué contenido empieza a afectar distribución, monetización, atribución y propiedad intelectual.
La arquitectura de la web se está adaptando a una realidad incómoda: cada vez más lectores no son personas y cada vez menos bots tienen el mismo propósito.